Im Juli 2026 begann die Arbeit an einem Test-and-Fix-Loop für eine neue Peakboard-Runtime. Der Loop startet ein Board in der aktuellen produktiven Runtime, die auf Windows Presentation Foundation (WPF) basiert, sowie in der neuen Web-Runtime. Ziel ist eine Web-Runtime, die jedes Board genauso darstellt wie die produktive Runtime, pixelgenau, soweit möglich und sinnvoll. Der Loop vergleicht die beiden Screenshots und lässt Claude Code, den Coding-Agenten von Anthropic, die Abweichung beurteilen. Weicht die Darstellung in der Web-Runtime ab, korrigiert Claude Code den Quellcode der Web-Runtime, und der Loop läuft erneut.
Peakboard ist eine Software für Dashboards auf Bildschirmen in Produktion und Logistik. Ein solches Dashboard heißt Board und besteht aus Controls wie Texten, Buttons und Charts. Ein Board wird im Peakboard Designer erstellt und von einer Runtime auf einem Bildschirm dargestellt. Die aktuelle Runtime im produktiven Einsatz ist eine mit WPF entwickelte Windows-Anwendung (siehe den englischen Artikel Porting the Peakboard runtime from UWP to WPF). Diese WPF-Runtime ist die Referenz. Die neue Web-Runtime läuft auf dem Peakboard Hub, dem zentralen Management-Server von Peakboard, und ist eine Beta-Funktion der On-Premise-Version. Jeder Bildschirm öffnet lediglich einen Link auf das Board in seinem Browser. Ein Self-Healing-Loop ist ein Test-Loop, der den getesteten Code selbstständig repariert und anschließend erneut testet.
Der Loop ist internes Tooling und nicht Teil des Produkts. Sein Code enthält keinen eigenen Modellaufruf. Claude Code läuft als Prozess im Headless-Modus. Im Headless-Modus wird Claude Code von einem Programm mit dem Prompt als Kommandozeilenargument gestartet. Claude Code arbeitet daraufhin, bis die Aufgabe erledigt ist, und gibt die Antwort an das Programm zurück. Der Rest ist .NET-8-Code, der Prozesse startet, Screenshots aufnimmt und Pixel vergleicht sowie baut und committet.
Zwei Screenshots und ein Diff-Bild
Der wichtigste Test des Loops ist der Vergleichstest. Er ist eine Form des Visual Regression Testing, das Screenshots mit einem Referenzbild vergleicht. Vor dem ersten Board wird die Web-Runtime einmal gebaut. Schlägt dieser Build fehl, endet der Lauf, und kein Board wird getestet. Anschließend startet der Loop die WPF-Runtime mit der Projektdatei, d. h. mit der Datei, die das Board enthält. Das Fenster wird in den Vordergrund geholt, damit kein anderes Fenster das Board verdeckt. Da ein Board direkt nach dem Start oft noch Ladezustände oder laufende Animationen zeigt, nimmt der Loop alle 1,2 Sekunden einen Screenshot des gesamten Monitors auf. Er hört auf, sobald sich zwei aufeinanderfolgende Screenshots in weniger als 0,2 Prozent ihrer Pixel unterscheiden. Ab diesem Punkt verändert sich das Board nicht mehr.
Dieser letzte Screenshot ist das Referenzbild und zeigt, wie das Board aussehen muss. Anschließend wird derselbe Ablauf mit der Web-Runtime durchgeführt. Ihr letzter Screenshot ist das Ist-Bild. Zusätzlich schreibt die Web-Runtime eine Log-Datei.
Daraufhin vergleicht der Loop die beiden Bilder Pixel für Pixel. Für jedes Pixel werden die Abweichungen im Rot-, Grün- und Blaukanal addiert. Liegt die Summe über 60, bei einem Höchstwert von 765, gilt das Pixel als abweichend. Anschließend erzeugt der Loop ein drittes Bild, das Diff-Bild. Es entspricht dem Referenzbild, in dem jedes abweichende Pixel eingefärbt ist. Rot markiert Inhalt der WPF-Runtime, der in der Web-Runtime fehlt oder an einer anderen Stelle liegt. Blau markiert Inhalt der Web-Runtime, der im Referenzbild nicht vorhanden ist.
Die nächsten drei Screenshots zeigen einen Ausschnitt eines Testboards mit Rechtecken aus dem ersten Lauf. Der folgende Screenshot zeigt das Referenzbild der WPF-Runtime.
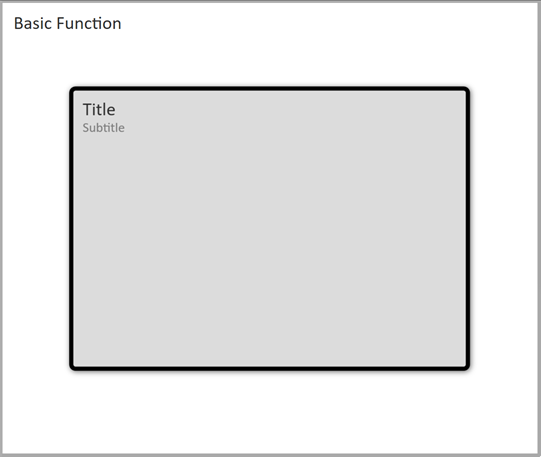
Der nächste Screenshot zeigt das Ist-Bild der Web-Runtime. Die Web-Runtime hat den Schatten um das Rechteck deutlich breiter gezeichnet als die WPF-Runtime.
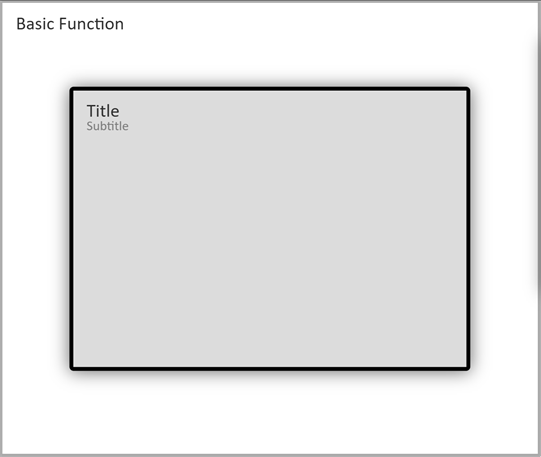
Der folgende Screenshot zeigt das Diff-Bild. Der zusätzliche Schatten erscheint als breiter blauer Rand.
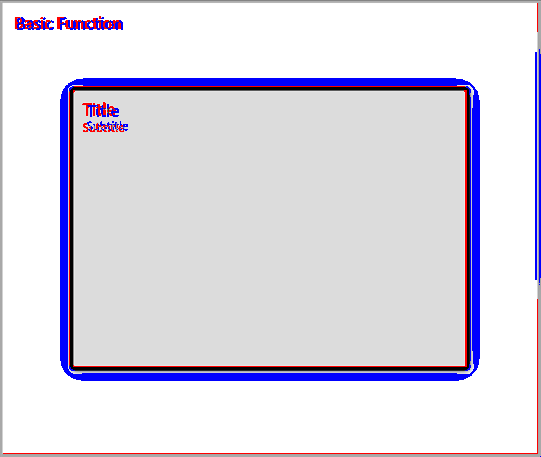
Die Texte erscheinen im Diff-Bild doppelt, einmal in Rot und einmal in Blau. Die Web-Runtime zeichnet sie 2 bis 4 Pixel weiter rechts und bis zu einem Pixel tiefer. Die Kanten der Buchstaben werden dabei etwas anders geglättet. Rot zeigt den Text der WPF-Runtime, Blau den Text der Web-Runtime.
Zusätzlich protokolliert der Loop den Anteil der abweichenden Pixel in Prozent. Ob ein Board den Test besteht, entscheidet dieser Wert allerdings nicht, da die Zahl der abweichenden Pixel wenig über die Ursache aussagt. Anti-Aliasing, d. h. die Glättung von Kanten in Texten und Linien, arbeitet in jeder Runtime etwas anders. Dadurch ändern sich zwar viele Pixel, aber das Board sieht richtig aus. Ein etwas anders gezeichnetes Chart kann 20.000 abweichende Pixel haben und dennoch korrekt sein. Eine falsche Statusfarbe hingegen kann nur 200 Pixel umfassen und dennoch ein Fehler sein. Ein Grenzwert für den Prozentwert würde die falsche Farbe durchlassen und das korrekte Chart als Fehler werten. Aus diesem Grund entscheidet Claude Code nach dem Muster LLM as a Judge. Dazu sieht sich Claude Code die drei Bilder sowie das Log an und beurteilt, ob die Abweichung ein Fehler ist.
Claude Code als Judge
Der Prompt umfasst rund 45 Zeilen deutschen Text im Code. Er enthält die Pfade der drei Bilder, der Log-Datei sowie der Projektdatei des Boards. Claude Code öffnet sie mit seinem eingebauten Read-Tool, das auch Bilder liest. Ein Modell, das neben Text auch Bilder verarbeitet, heißt multimodal. Die folgenden Zeilen zeigen die wichtigsten Regeln des Prompts in gekürzter Form:
wpf.png ist der Screenshot der WPF-Runtime, die Referenz. web.png ist der aktuelle
Screenshot der Web-Runtime. diff.png markiert die Abweichungen: ROT = Inhalt der
WPF-Runtime, der in der Web-Runtime fehlt oder woanders liegt, BLAU = Inhalt der
Web-Runtime, der in der Referenz nicht dort ist. Nur als Hinweis, pixelgenau wird es nie sein.
web.log ist das Log der Web-Runtime. Prüfe es auf Skript- und Datenquellen-Fehler.
NUR reine Rendering-Nuancen sind akzeptabel (Anti-Aliasing, leicht anderes Font-Rendering,
1 bis 2 Pixel Versatz). Dann tue NICHTS und antworte als letzte Zeile exakt RESULT: OK.
Charts: Hier sei toleranter, aber Typ, Werte, Farben, Achsen und Legende müssen stimmen.
ECHTE Fehler sind IMMER zu beheben, auch wenn die Fläche klein ist: falsche FARBEN (die
zeigen oft einen Zustand an), falsche oder fehlende Texte und Werte, fehlende Elemente,
deutlich falsche Position oder Größe. Die Größe der Fläche ist KEIN Kriterium.
Du darfst ALLES ändern, was nötig ist.
Alles ist per Git abgesichert, sei mutig statt vorsichtig.
Ist die Ursache nicht spezifisch für dieses Control, behebe sie an der GEMEINSAMEN Stelle.
Du musst NICHT selbst bauen, das übernimmt das aufrufende Tool nach deiner Antwort.
Wenn du Code geändert hast, antworte als letzte Zeile exakt RESULT: FIXED.
Ein kurzer Prompt („vergleiche und fixe“) würde zwei Fehler zulassen. Das Modell würde jede kleine Rendering-Abweichung als Fehler behandeln und den Code ändern. Oder es würde einen echten Fehler wegen der kleinen Fläche durchlassen. Der lange Prompt schließt beide Fehler aus. Die Beispiele zeigen, wo ein Fehler beginnt. Anti-Aliasing ist kein Fehler, eine falsche Statusfarbe hingegen schon. Die Regel für gemeinsame Fixes verhindert, dass Claude Code ein Board nach dem anderen korrigiert.
Der Loop durchsucht die Ausgabe nach der RESULT-Zeile. Fehlt sie, fragt der Loop in derselben Unterhaltung erneut nach. Enthält auch die zweite Antwort keinen Marker, wird das Board übersprungen.
Fix, Build und erneuter Test
Nach der Antwort FIXED baut der Loop die Web-Runtime, nimmt einen neuen Screenshot auf und vergleicht erneut. Je Board sind bis zu drei Fix-Versuche möglich. Ein Build-Fehler beendet den Test des Boards. Die Compiler-Ausgabe wird dabei in das Log geschrieben und nicht an Claude Code zurückgegeben.
Eine Session ist eine Unterhaltung mit Claude Code samt ihrem Kontext. Der Loop merkt sich die Session-ID von Claude Code. Jeder neue Versuch und jedes neue Board setzt dieselbe Session mit dem Flag –resume fort. Dadurch muss Claude Code die Codebase nicht für jedes Board neu einlesen. Die Bilder übergibt der Loop nur als Dateipfade und nicht im Prompt. Die Entscheidung, was das Modell in seinem Kontext behält, heißt Context Engineering. Der Aufruf verwendet das Claude-Modell Opus 4.8 mit dem Effort-Level high, der Einstellung für den Reasoning Effort des Modells. Ein höherer Effort lässt das Modell vor der Antwort länger nachdenken.
Nach der Antwort OK und mindestens einem Fix committet der Loop die Änderungen. Committet wird nur auf einem eigenen, ausgecheckten Test-Branch, und ein Push erfolgt nie. Nach jeder Antwort OK schreibt der Loop eine Marker-Datei, die das Board als bestanden kennzeichnet. Ein erneuter Lauf durch einen Tester entfernt sie.
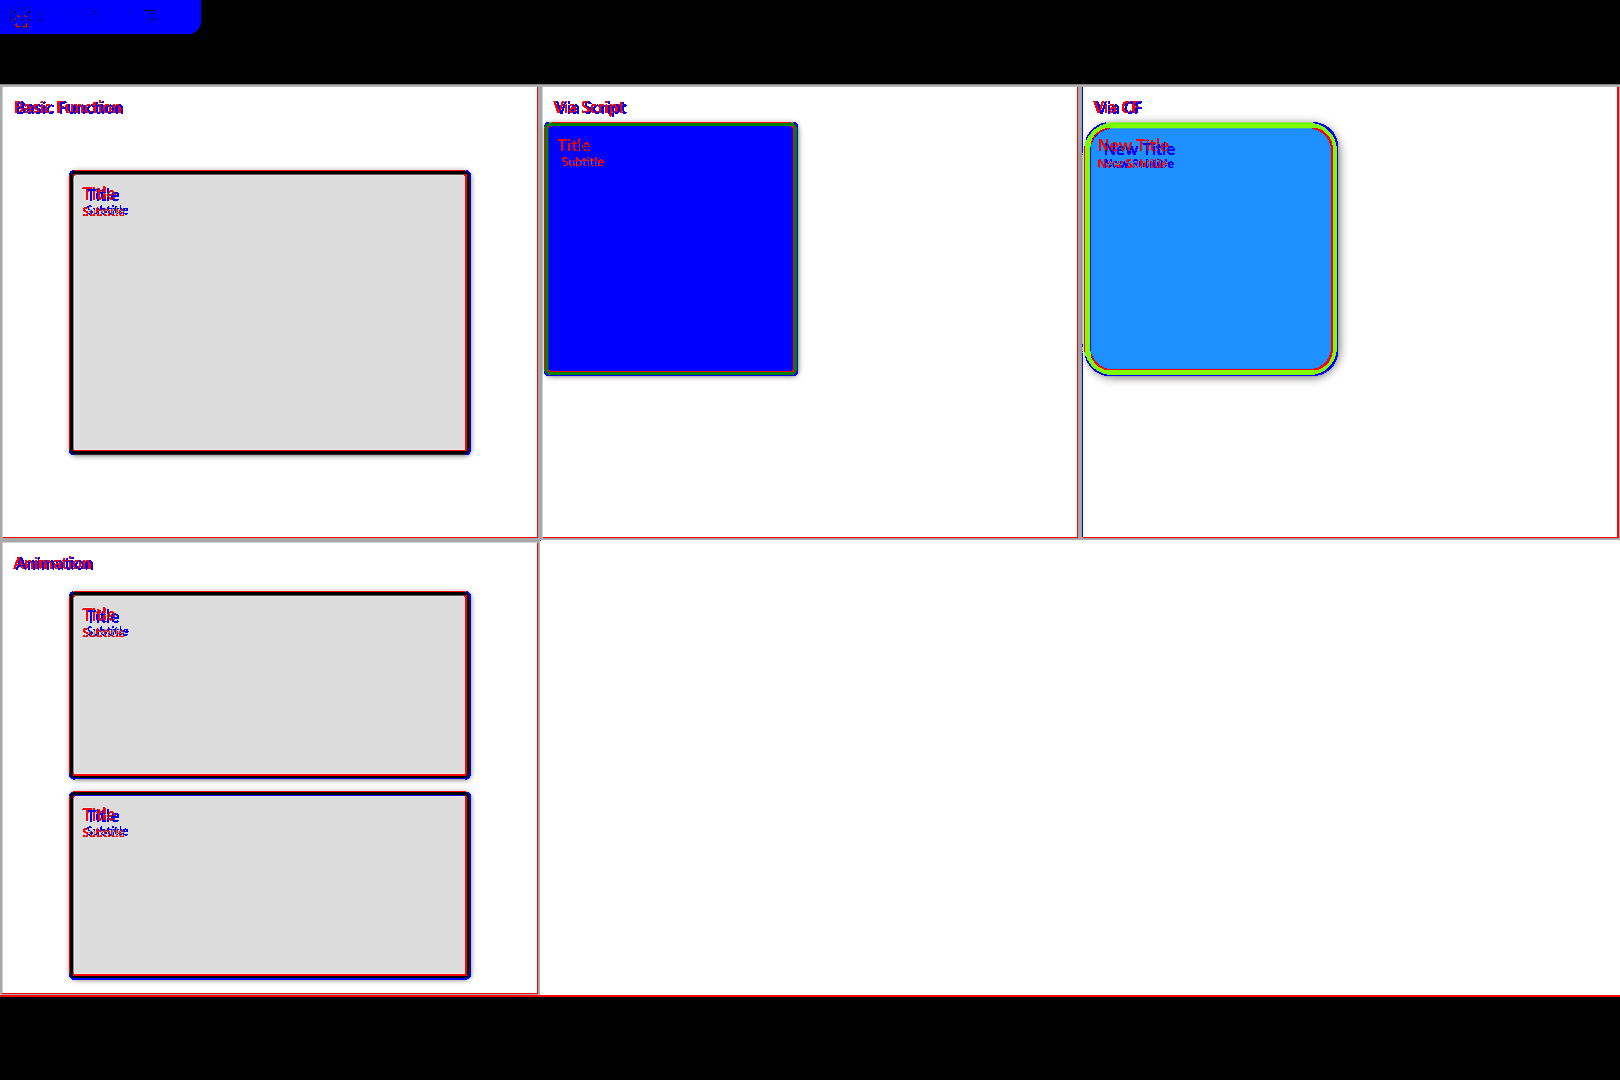
Der nächste Screenshot zeigt das Diff-Bild des gesamten Boards nach Fixes in der Web-Runtime. Die Schatten sehen inzwischen gleich aus, und die breiten blauen Ränder sind verschwunden. Die Texte erscheinen weiterhin in Rot und Blau, da sie in der Web-Runtime nach wie vor 2 bis 4 Pixel weiter rechts liegen. Die dünnen Linien an den Rahmen entstehen durch Anti-Aliasing und einen Versatz von einem Pixel.
Feedback von Testern
Tester sind die Personen, die die Web-Runtime zusätzlich von Hand prüfen. Sie starten Läufe über die Desktop-App des Loops oder über eine kleine Webseite auf dem Testrechner. Die Seite funktioniert auch auf einem Handy im lokalen Netz. Sie zeigt die Ergebnisse je Board mit dem WPF-Bild und dem Web-Bild jedes Laufs. Ein Tester kann einem Board einen Kommentar hinzufügen und es erneut starten. Der Kommentar wird als Hinweis des Testers in den Prompt übernommen. Damit wird der Loop zu einem Human-in-the-Loop-System, in dem ein Mensch das Urteil des Modells korrigieren kann.
Ein erneuter Lauf über die Webseite kann zusätzlich einen Anhang enthalten, z. B. einen Screenshot vom Handy. In diesem Fall entfällt der Screenshot-Vergleich. Claude Code behebt das beschriebene Problem, der Loop baut und committet, und die Commit-Message enthält den Kommentar.
Control-Tests und Demo-Tests
Der Vergleichstest sieht nur das Board direkt nach dem Start, vor jeder Eingabe. Zwei weitere Testarten prüfen, was nach einem Klick oder einer Eingabe geschieht. Ein Control-Test prüft, ob die Web-Runtime überhaupt reagiert. Ein Demo-Test prüft, ob sie genauso reagiert wie die WPF-Runtime.
Für einen Control-Test wird die Web-Runtime ohne Fenster gestartet, und Playwright öffnet das Board in Chromium, dem Open-Source-Browser hinter Google Chrome. Playwright ist eine Library für Browser-Automation. Vor jedem Schritt führt der Loop über Playwright eine kurze JavaScript-Funktion in der Seite aus. Diese listet bis zu 60 sichtbare HTML-Elemente auf, die sich anklicken oder ausfüllen lassen, z. B. Buttons und Textfelder. Jeder Eintrag enthält den Text des Elements und seinen Mittelpunkt auf dem Bildschirm.
Claude Code erhält diese nummerierte Liste sowie den letzten Screenshot. Daraufhin wählt Claude Code ein Element aus und antwortet mit einer Zeile in JSON, einer einfachen Form von Structured Output, die der Loop auswerten kann. Die Zeile enthält die Nummer des Elements und bei einem Textfeld den einzugebenden Text. Playwright klickt anschließend auf den Mittelpunkt oder tippt den Text und nimmt den nächsten Screenshot auf. Jeder Schritt ist ein neuer Aufruf von Claude Code ohne Session. Den einzigen Kontext bilden die Screenshots des Laufs. Beobachten, entscheiden, handeln und erneut beobachten ist der grundlegende Agent Loop. Das Modell entscheidet dabei nur, und Playwright führt die Aktion aus.
Nach höchstens 6 Schritten oder wenn Claude Code fertig ist, sieht sich Claude Code alle Screenshots sowie das Log an. Da es hier kein Referenzbild gibt, beurteilt Claude Code, ob das Board plausibel reagiert. Dabei wird geprüft, ob Klicks und Eingaben eine sichtbare Wirkung haben. Zusätzlich wird geprüft, ob die Screenshots fehlerhafte Bereiche zeigen und das Log Fehler enthält. Die Antwort endet mit RESULT: OK oder RESULT: PROBLEM. Ein Control-Test meldet Probleme, behebt jedoch nichts.
Ein Demo-Test verwendet ein Demo-Board, d. h. ein Board, das sich selbst bedient. Es läuft einmal in der WPF-Runtime und einmal in der Web-Runtime. Nach 6 Sekunden startet ein Timer im Board ein Skript in Lua, der Skriptsprache von Peakboard. Das Skript führt alle 4 Sekunden einen Schritt aus. Jeder Schritt sendet eine Anfrage über HTTP an einen kleinen Control-Server auf dem Testrechner. Angefragt wird ein Klick, eine Texteingabe oder ein Screenshot. Der Server bewegt die echte Maus mit der Windows-Funktion SendInput und nimmt die Screenshots auf. Dadurch erhalten beide Runtimes an derselben Stelle der Demo dieselbe Eingabe.
Jeder Screenshot-Schritt liefert ein Paar aus Referenz- und Ist-Bild sowie ein Diff-Bild, wie im Vergleichstest. Claude Code erhält alle Paare mit denselben Regeln und einem zusätzlichen Fehlertyp. Der neue Fehlertyp ist ein Klick oder eine Eingabe, auf die nur die WPF-Runtime reagiert. Anders als der Control-Test behebt der Demo-Test Fehler in der Web-Runtime. Er hat bis zu fünf Fix-Versuche. Nach jedem Fix baut der Loop die Web-Runtime und spielt die Demo erneut ab.
Der Loop ist vom agentischen Testsystem für die Benutzeroberfläche des Peakboard Designers getrennt. Das Testsystem für den Designer lässt das Modell die Anwendung mit den Tools eines Model-Context-Protocol-Servers (MCP) erkunden und Notizen führen. Dieser Loop hingegen gibt dem Modell fertige Bilder und eine eng umrissene Aufgabe, und das Modell ändert den Produktcode.
Das war’s.
Bei Fragen gerne melden.
Links:
Peakboard →
Claude Code, programmatisch ausführen →
Playwright für .NET →
Funktion SendInput →