Im März 2026 begann die Arbeit an einem Testsystem für den Peakboard Designer, eine mit Windows Presentation Foundation (WPF) entwickelte Anwendung. Ein KI-Agent, Claude Code, bedient die Benutzeroberfläche (UI) über Windows UI Automation wie ein menschlicher Tester, beurteilt das Ergebnis und meldet jeden gefundenen Fehler. Alles, was wiederholt werden muss, läuft ohne Sprachmodell und wird von einem separaten Runner als JSON-Testskript ausgeführt.
Der Peakboard Designer ist der Editor für Boards, d. h. für die Anzeigen, die Peakboard auf einem Bildschirm darstellt. Er bietet eine Arbeitsfläche, eine Toolbox mit den Steuerelementen, Eigenschaftsdialoge sowie ein eigenes Dateiformat für Projekte. Der folgende Screenshot zeigt ein Board mit sechs Stationen auf der Arbeitsfläche sowie rechts die Eigenschaften eines Text-Steuerelements.
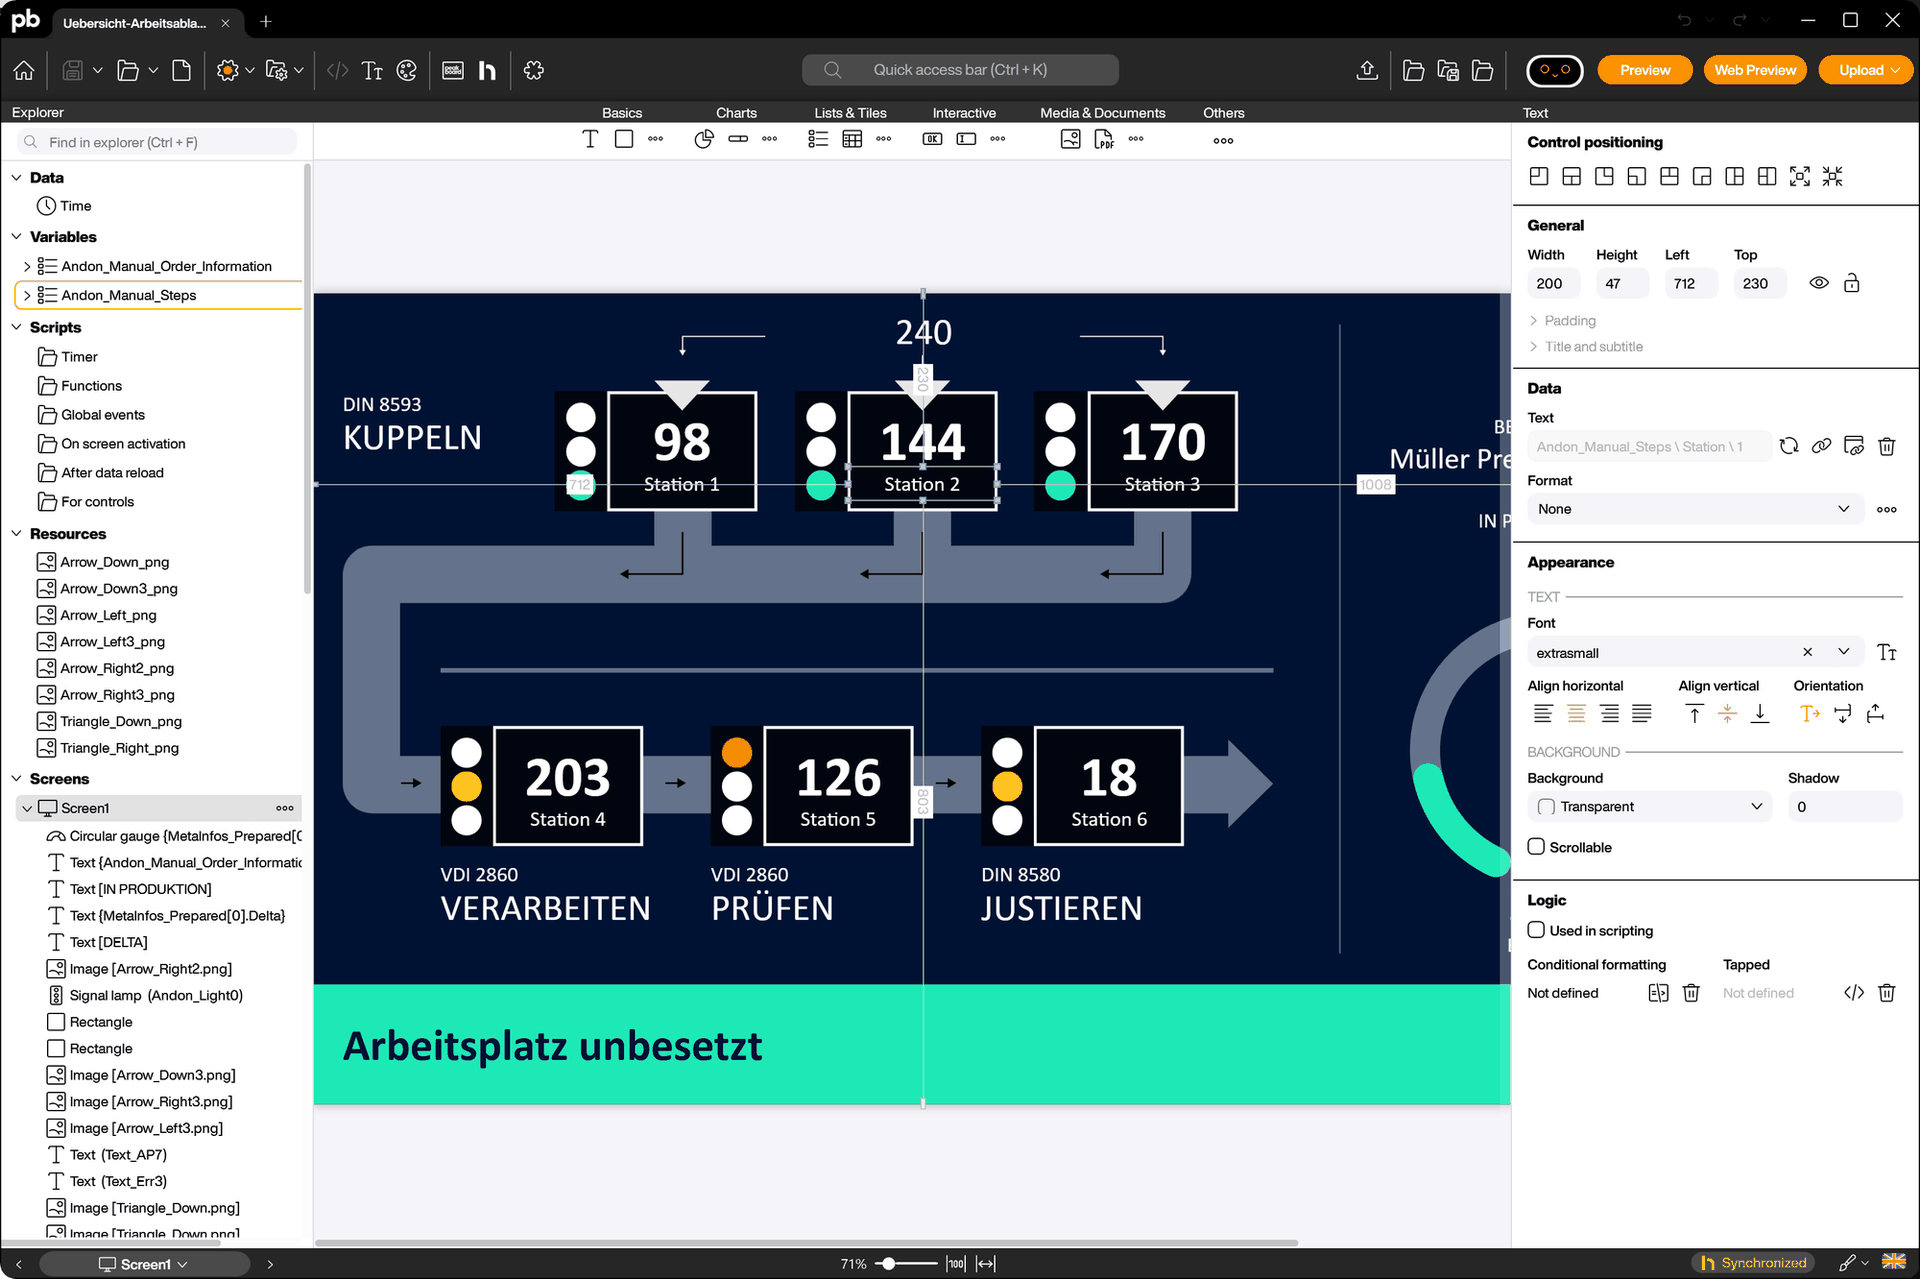
Das Testsystem ist ein internes Werkzeug zum Testen des Designers und nicht Teil des Produkts.
Die Idee
Agentisch heißt, dass ein Sprachmodell ein Tool aufruft, das Ergebnis liest und den nächsten Schritt selbst festlegt. Ein Tool ist eine Funktion, die ein anderes Programm dem Modell anbietet, z. B. ein Klick auf ein Element oder das Lesen eines Werts. Das Modell übernimmt alles, was Verständnis erfordert. Es erkundet einen unbekannten Dialog, wählt den nächsten Klick, prüft einen Wert und schreibt den Fehlerbericht. Für alles, was jedes Mal auf dieselbe Weise wiederholt werden muss (z. B. eine nächtliche Regressionssuite), wird ein Runner ohne Modell eingesetzt.
Der Code des Systems ruft nie ein Modell auf. Das Modell steckt allein in Claude Code, das als eigener Prozess mit einem Prompt und mehreren Tools läuft. Der Rest ist .NET, Markdown und JSON.
Das folgende Diagramm zeigt die Teile und die Verbindungen zwischen ihnen.
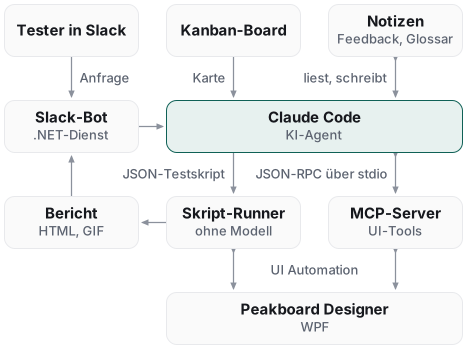
Ein Tester schreibt eine Anfrage in Slack. Daraufhin startet ein Bot Claude Code mit dem Prompt für das Testen und dem Text der Anfrage. Eine Karte auf einem Kanban-Board, einer Aufgabentafel mit Spalten, startet Claude Code ebenfalls. Ein Lauf ist ein solcher Start von Claude Code, vom ersten Schritt bis zur Ergebniszeile, mit der jeder Lauf endet. Claude Code startet den MCP-Server als Kindprozess, liest die eigenen Notizen und bedient die Anwendung über die Tools des Servers.
Soll ein Ablauf später wiederholt werden, schreibt Claude Code ein JSON-Testskript und startet damit den Runner. Der Bericht sowie die Befunde, d. h. die gemeldeten Probleme der Anwendung, werden an Slack gesendet. Neue Erkenntnisse ergänzt der Agent in seinen Notizen.
Der MCP-Server
Das Model Context Protocol (MCP) ist der offene Standard, über den ein Modell Tools in einem anderen Programm aufruft. Der Server ist ein Konsolenprozess auf Basis von .NET 8, der von Claude Code als Kindprozess gestartet wird. Über stdin werden JSON-RPC-Nachrichten an den Server gesendet und die Antworten über stdout mit einer Nachricht je Zeile zurückgegeben.
Der Server implementiert die drei Methoden initialize, tools/list und tools/call. Die Nachrichtenschleife dafür wurde ohne Software Development Kit (SDK) von Hand geschrieben, da das Protokoll klein ist.
Die Tools verwenden Windows UI Automation, die Schnittstelle von Windows, über die ein Programm die Oberfläche eines anderen Programms liest und bedient. Jedes Fenster, jeder Button und jedes Textfeld ist darin ein Element mit Eigenschaften, und die Elemente bilden einen Baum, im Folgenden UI-Baum genannt. Der Server verwendet System.Windows.Automation, die verwaltete UI-Automation-API von .NET. Über eine Umgebungsvariable lässt sich stattdessen die Bibliothek FlaUI einsetzen, die mit der neueren, auf dem Component Object Model (COM) basierenden Schnittstelle von UI Automation arbeitet.
Der Server stellt mehr als 30 Tools in vier Gruppen bereit. Die Lese-Tools liefern den UI-Baum, ein einzelnes Element, dessen Text oder eine Eigenschaft sowie die Liste der geöffneten Fenster. Mit den Aktions-Tools werden Klick, Doppelklick, Rechtsklick, Hover, Texteingabe, Tastendrücke, Listenauswahl sowie Drag-and-drop ausgeführt. Die Assertion-Tools prüfen Existenz, Sichtbarkeit, Bedienbarkeit, Wert und Text eines Elements. Weitere Tools stehen für das Warten, für Screenshots und Videoaufzeichnungen sowie für den Build der Anwendung und den Commit in Git zur Verfügung.
Die Elementsuche verwendet zunächst die AutomationId, d. h. die vom Entwickler für ein Steuerelement vergebene feste ID. Fehlt sie, bleibt die Eigenschaft Name.
Die zentrale Entscheidung des Entwurfs ist, dass das Modell weder Screenshots noch den vollständigen UI-Baum erhält. Beides würde den Kontext des Modells mit Daten füllen, die es für den nächsten Schritt nicht benötigt. Ein Klick kann stattdessen einen Diff des Baums liefern, d. h. die hinzugekommenen, verschwundenen und geänderten Elemente, je Art höchstens 30. Zusätzlich liefert er immer einen Bericht über die geöffneten und geschlossenen Fenster. Das folgende JSON zeigt die Antwort auf einen Klick auf das Menü „File“:
{ "success": true, "automationId": "MainMenu_File", "executionMs": 2840,
  "diff": { "appeared": ["FileMenu_New", "FileMenu_Open"], "disappeared": [], "changed": [] },
  "activeDialog": null, "windows": { "count": 1, "opened": [], "closed": [] } }
Das Feld executionMs enthält die Antwortzeit in Millisekunden. Der Wert ist hoch, da für diesen Klick der Diff eingeschaltet war. Unter diff stehen die AutomationIds der beiden Menüpunkte, die durch den Klick erschienen sind. Das Feld activeDialog ist null, da der Klick keinen Dialog geöffnet hat.
Der Diff benötigt zwei Momentaufnahmen des Baums, eine vor und eine nach dem Klick. Das erhöht die Antwortzeit von etwa 200 auf etwa 3000 Millisekunden. Standardmäßig ist der Diff ausgeschaltet. Das Modell aktiviert ihn über einen Parameter, wenn es die Änderungen eines Klicks benötigt. Beide Zeiten stehen in der Toolbeschreibung, die das Modell liest, damit es den Diff nur bei Bedarf einschaltet.
Der Fensterbericht ist Teil jeder Antwort, damit dem Modell kein neuer Dialog entgeht. Vollständige Bäume und Screenshots speichert das Tool auf der Festplatte und gibt nur den Dateipfad und nie den Inhalt zurück.
Der Agent besteht aus Markdown-Dateien
Das Repository enthält keinen KI-Code, da der Agent aus Claude Code und Prompts in Markdown besteht. Eine Rolle ist eine Markdown-Datei mit Anweisungen, in Claude Code ein sog. Command. Beginnt der Prompt mit dem Namen der Datei, z. B. /test für die Testrolle, lädt Claude Code die Datei als Anweisung für den Lauf. Weitere Rollen schreiben ein Konzept, setzen eine Aufgabe um oder schreiben Dokumentation.
Der Test-Prompt hat etwa 250 Zeilen und enthält zwei Grundsätze, fünf Regeln sowie das Format der Ergebniszeile. Die Grundsätze gehen jeder anderen Regel vor. Die Details stehen in Referenzdateien, eine je Thema (z. B. der Umgang mit den Notizen, die Fehlersuche, das Live-Testen und das Schreiben von Skripten), die Claude Code nur bei Bedarf liest.
Der erste Grundsatz heißt „live first“. Live heißt, dass der Agent die Anwendung direkt über die MCP-Tools bedient und das Ergebnis nach jedem Schritt selbst prüft. Das ist der Standard. Ein JSON-Testskript wird nur geschrieben, wenn ein Ablauf später erneut laufen muss (z. B. für einen nächtlichen Lauf, eine Regressionssuite oder die dauerhafte Reproduktion eines Fehlers).
Der zweite Grundsatz heißt „memory first“. Der Agent liest vor dem ersten Klick seine Notizen. Bei einem fehlgeschlagenen Schritt durchsucht er die Notizen nach dem Symptom, statt den Aufruf zu wiederholen.
Fünf Regeln bestimmen die Qualität eines Laufs:
- Ein Round-Trip für jeden Wert (abweichenden Wert setzen, speichern, erneut öffnen, zurücklesen)
- Keine geratenen AutomationIds, nur solche aus dem aktuellen UI-Baum
- Bei jedem Fehlschlag ein Blick in die Notizen statt einer Wiederholung
- Eine Korrektur im Quellcode für jede fehlende AutomationId, kein Umweg über Name oder Koordinate
- Ein Befund für jeden Fehler der Anwendung, auch bei bestandenem Test
Die erste Regel geht auf einen Fehler in einem Verbindungsdialog zurück, in dem eine Portnummer nach dem Speichern und erneuten Öffnen der Datei wieder auf dem Standardwert stand. Gefunden wurde der Fehler nur, weil der Test einen abweichenden Wert gesetzt, gespeichert, die Datei erneut geöffnet und den gespeicherten Wert geprüft hat. Ohne einen dieser vier Schritte bleibt der Fehler unsichtbar.
Memory, Feedback und Glossar
Claude Code beginnt jeden Lauf ohne Erinnerung an frühere Läufe. Ohne Notizen müsste der Agent jedes bekannte Problem der Anwendung in jedem Lauf erneut finden. Die Notizen sind Markdown-Dateien im Repository, derzeit rund tausend.
Ein Inhaltsverzeichnis, der sog. Router, listet etwa 30 Themen mit jeweils einer Zeile. Eine Themendatei listet ihre Notizen ebenfalls mit jeweils einer Zeile und verweist auf die benachbarten Themen. Zunächst liest der Agent den Router, öffnet anschließend ein bis drei Themen und folgt höchstens einem Verweis. Bei einem Fehlschlag werden die Notizen nach dem Symptom (z. B. „value reverts“, der Wert springt zurück) und nicht nach dem Namen der Funktion durchsucht.
Es gibt drei Arten von Notizen. Eine Fehlernotiz beschreibt einen fehlgeschlagenen Schritt, seine Ursache und den Schritt, der stattdessen funktioniert. Eine Workflow-Notiz enthält eine geprüfte Folge von Schritten. Eine Prüfnotiz hält das Ergebnis der Prüfung einer Funktion oder einer Aufgabe fest.
Ein Beispiel ist eine Fehlernotiz zu einem Kombinationsfeld (ComboBox). Die Eingabetaste schloss dort den gesamten Dialog, da WPF sie an den Standard-Button des Dialogs sendet. Die Notiz nennt den Schritt, der funktioniert: die Autovervollständigung mit der Pfeiltaste nach unten übernehmen und anschließend auf den Button „OK“ klicken.
Neben den Notizen liest der Agent zwei weitere Quellen, das Feedback und das Glossar. Das Feedback enthält zwei Dutzend Regeln von Testern und Entwicklern. Ein Tester legt eine Regel in Slack mit einer Nachricht an, die mit „remember“ beginnt. Jede Regel hat einen Geltungsbereich (z. B. Test oder Dokumentation). Jeder Lauf liest die Regeln, wendet sie an und nennt im Bericht die Nummern der angewendeten Regeln.
Das Glossar enthält je Sprache die erlaubten Begriffe mit einer Definition sowie die falschen Begriffe mit ihrem Ersatz. Jede Rolle liest das Glossar, bevor sie Text für Menschen schreibt, z. B. einen Fehlerbericht oder einen Hilfeartikel.
Der Skript-Runner
Der Runner ist ein Konsolenprogramm, das JSON-Testskripte ausführt. Er verwendet dieselbe Elementsuche und denselben Klick-Code wie der MCP-Server. Ein Klick des Modells und ein Klick aus einem Skript laufen damit durch denselben Code.
Ein Skript besteht aus einem Setup, das die Anwendung in den Ausgangszustand bringt, den Schritten, einem Teardown, das danach aufräumt, sowie Variablen und Importen. Es gibt zwölf Schritttypen (z. B. action, assert, wait_for, store, if, for_each sowie run für ein Unterskript). Das Format wird durch eine Schemadatei definiert. Ein unbekannter Schritttyp wird beim Laden des Skripts abgelehnt.
Für einen Schritt vom Typ action können die Elemente angegeben werden, die im Baum erscheinen oder verschwinden müssen. Ohne diese Angabe gilt ein Doppelklick auf ein Symbol der Toolbox auch dann als bestanden, wenn nichts passiert. Mit der Angabe schlägt der Schritt fehl, wenn nichts erscheint oder verschwindet.
Nach jedem Schritt führt der Runner sieben Zustandsprüfungen aus, in der Testliteratur Testorakel genannt. Unabhängig vom Schritt selbst erkennen sie die folgenden Zustände der Anwendung:
- Der Prozess der Anwendung wurde beendet
- Ein Fenster beantwortet eine Nachricht nicht innerhalb eines Timeouts
- Ein neues Fenster ist erschienen, gemeldet durch einen WinEvent-Hook (eine Benachrichtigung von Windows bei jedem neuen Fenster), auch wenn es bereits wieder geschlossen wurde
- Ein neues Fenster ist erschienen, gefunden durch regelmäßiges Abfragen der Fensterliste (Polling), falls der Hook ausfällt
- Im Fenster ist ein Label mit einer Fehlermeldung sichtbar
- Die Logdatei der Anwendung enthält neue Fehlerzeilen
- Das Anwendungsprotokoll der Windows-Ereignisanzeige enthält neue Einträge der Anwendung
Ein Absturzdialog wird an seinem Inhalt und nicht an seinem Titel erkannt, da der WPF-Dialog für eine unbehandelte Ausnahme den normalen Titel der Anwendung trägt. Hierzu liest der Runner den Text eines neuen Fensters und sucht nach einem Ausnahmetyp, einer Zeile des Stacktraces oder den beiden Buttons zum Fortsetzen und Beenden.
Der Runner schreibt einen HTML-Bericht mit einer Tabelle der Schritte und Screenshots, ein GIF aus den Screenshots sowie eine Zeile je Lauf in eine SQLite-Datenbank. Für jeden Befund wird ein Fingerprint erzeugt, ein Hash über den Namen der Zustandsprüfung, den bereinigten Fenstertitel und die erste Zeile des Stacktraces. Gleicher Fingerprint heißt gleicher Befund. Ein von zehn Skripten gefundener Absturz ist damit ein Problem und nicht zehn.
Zusätzlich gibt es einen Random Walk, ein Skript aus zufällig gewählten Operationen. Eine Operationsdatei listet vier Operationen, die die Anwendung jeweils wieder in den Ausgangszustand bringen und sich dadurch in beliebiger Reihenfolge aneinanderreihen lassen (z. B. das Anlegen eines Textblocks mit anschließendem Undo). Ein Generator wählt daraus zufällig 40 Operationen aus und schreibt ein normales Skript. Ein Seed, der Startwert für die Zufallszahlen, legt die Auswahl fest. In jeder Nacht werden drei Walks ausgeführt. Mit demselben Seed entsteht dasselbe Skript, ein Absturz aus einem nächtlichen Lauf lässt sich damit reproduzieren.
Fehlende AutomationIds
UI Automation findet ein Element über seine AutomationId, die der Entwickler in der Extensible Application Markup Language (XAML) setzt. Ohne AutomationId bleiben nur der Name oder eine Koordinate. Beides ist unzuverlässig, da sich der Name mit der Sprache oder dem Inhalt ändert und die Koordinate mit der Fenstergröße. Der Test-Prompt verbietet beides und behandelt eine fehlende ID als Fehler der Anwendung.
Die Korrektur übernimmt ein zweiter Agent, ein sog. Subagent. Der Hauptagent startet ihn mit einer Aufgabe, und nach deren Erledigung kehrt der Subagent mit einem Ergebnis zurück. Den Aufgabentext liefert ein Tool des MCP-Servers fertig. Der Subagent verfügt über keine UI-Tools, sondern nur über Datei-Tools. Im XAML- oder C#-Quellcode sucht er das Element, ergänzt die AutomationId mit einem Namen aus Bereich, Steuerelementtyp und Zweck und ändert sonst nichts.
Der Subagent korrigiert höchstens 50 Elemente je Lauf. Nach seiner Rückkehr baut der Hauptagent die Anwendung mit dem Build-Tool, prüft die neuen IDs im UI-Baum der neu gebauten Anwendung, schreibt eine Notiz und committet die Änderung.
Slack und das Kanban-Board
Ein Bot verbindet Slack mit dem Testrechner. Der Bot ist ein .NET-Dienst ohne Modell und verwendet die Bibliothek SlackNet im Socket Mode. Dabei baut der Bot die Verbindung zu Slack selbst auf und benötigt keinen öffentlichen Endpunkt. Zunächst prüft der Bot den Absender gegen eine Liste erlaubter Benutzer und nimmt das erste Wort der Nachricht als Command. Anschließend startet der Bot Claude Code im Headless-Modus, d. h. ohne interaktives Terminal, mit dem Command und dem Text der Anfrage und liest die Ausgabe als JSON-Stream.
Aus dem Stream liest der Bot die Session-ID, die Kennung, unter der Claude Code den Lauf speichert. Alle vier Sekunden sendet er die neuen Tool-Aufrufe und Nachrichten des Agenten an Slack. Die letzte Zeile eines Laufs ist die Ergebniszeile mit dem Pfad des HTML-Berichts oder einem Fehlertext. Der Bot lädt den Bericht und das GIF hoch und speichert die Session-ID je Kanal.
Eine spätere Nachricht im selben Kanal setzt dieselbe Session fort. Hierzu startet der Bot Claude Code mit der gespeicherten Session-ID und dem Resume-Flag. Ein Tester kann dadurch eine Frage zu Schritt 12 des Berichts stellen und erhält eine Antwort mit dem vollständigen Kontext des Laufs.
Da auf dem Desktop nur eine Instanz der Anwendung laufen kann, wird jeweils nur ein Lauf ausgeführt. Weitere Anfragen warten in einer Warteschlange. Der Bot läuft als geplante Aufgabe bei der Anmeldung und nicht als Windows-Dienst, da UI Automation einen angemeldeten Benutzer mit sichtbarem Desktop benötigt.
Im Juli 2026 kam das Kanban-Board als zweiter Weg hinzu, einen Lauf zu starten. Eine Karte auf dem Board ist eine Aufgabe. Für jede Karte startet das Board Claude Code in einer Rolle, zunächst zum Entwickeln und danach in einem zweiten Lauf zum Testen. Der Testlauf verlässt sich nicht auf Prüfungen des Entwicklungslaufs. Eine Zeile im Test-Prompt legt fest, dass eine gerade entwickelte Karte als ungetestet gilt.
Grenzen
Vier Stellen sind bewusst einfach gehalten:
- Im Live-Modus läuft keine Zustandsprüfung. Ob ein Fehler vorliegt, entscheidet allein der Agent.
- Der Random Walk wählt aus nur vier Operationen. Er deckt damit einen kleinen Teil des Designers ab.
- Der Slack-Bot hält die Session je Kanal, nicht je Thread, und nur im Arbeitsspeicher. Nach einem Neustart beginnt jeder Kanal von vorn.
- Die Notizen sind Textdateien. Der Agent findet sie über den Router und grep, ohne Embeddings, Fine-Tuning oder einen zweiten Modellaufruf.
Ein zweiter Artikel beschreibt eine kleinere Variante dieses Systems mit Code zum Ausprobieren.
Das war’s.
Bei Fragen gerne melden.
Links:
Model Context Protocol →
Claude Code, programmatisch ausführen →
Claude Code, Skills und Commands →
Claude Code, Subagents →
Übersicht zu UI Automation →
FlaUI →
SlackNet →